Data Loss Prevention yang efektif berdiri di atas satu fondasi: data classification yang akurat. Tanpa klasifikasi yang jelas, policy DLP berbasis tebakan — akan menangkap terlalu banyak false positive atau melewatkan data sensitif yang harusnya dilindungi. Digital Guardian Data Classification adalah engine yang mengotomatisasi proses identifikasi data sensitif di seluruh organisasi. Artikel ini menjelaskan cara kerja engine klasifikasi, setup taxonomy yang sesuai konteks organisasi Indonesia, dan implementasi step-by-step bersama PARAMA.
Apa itu Data Classification dan Mengapa Krusial untuk DLP
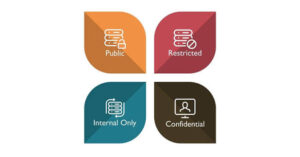
Data classification adalah proses mengkategorikan data berdasarkan tingkat sensitivitas dan kebutuhan proteksinya. Klasifikasi umum di enterprise modern: Public (data yang aman untuk dipublikasikan), Internal (untuk konsumsi internal organisasi), Confidential (data sensitif yang akses-nya terbatas berdasarkan need-to-know), dan Restricted (data ultra-sensitif yang akses-nya sangat ketat — biasanya data finansial, source code, atau strategi bisnis kritis).
Klasifikasi ini krusial untuk DLP karena policy DLP umumnya bertingkat sesuai sensitivity: data Public boleh disebar bebas, data Internal hanya boleh dishare internal, data Confidential memerlukan enkripsi saat transfer eksternal, dan data Restricted memerlukan approval explicit sebelum ada movement. Tanpa klasifikasi yang akurat, policy ini tidak bisa dijalankan dengan tepat.
Cara Kerja Engine Klasifikasi Digital Guardian
Engine klasifikasi Digital Guardian menggabungkan beberapa teknik untuk akurasi maksimal:
Regex pattern matching. Engine mengenali pola standar seperti nomor kartu kredit (format Luhn check), nomor KTP/NIK Indonesia (16 digit dengan format khusus), nomor BPJS Kesehatan, NPWP, nomor rekening bank Indonesia (berbeda per bank), dan format ID lainnya.
Dictionary lookup. Untuk data yang spesifik klien (misal: daftar nasabah VIP, kode produk rahasia, nama proyek confidential), engine dapat mengonsumsi dictionary kustom — list kata kunci yang dianggap sensitif berdasarkan konteks klien.
Machine Learning classifier. Untuk konten kompleks yang tidak terlihat lewat pattern atau dictionary (misal: paragraf strategi bisnis, kode source code proprietary, dokumen legal), engine ML mempelajari pola dari training data klien dan dapat klasifikasi dokumen baru berdasarkan kesamaan kontekstual.
Metadata analysis. Engine juga melihat metadata file: lokasi penyimpanan (folder “Restricted”), pemilik dokumen (CEO atau CFO biasanya memiliki dokumen sensitif), tag yang sudah ada, dan history versi.
Manual override. Untuk dokumen kritis yang klasifikasi otomatisnya tidak yakin, engine meminta user (atau approver) untuk konfirmasi klasifikasi sebelum policy diterapkan. Ini menjaga akurasi dan menurunkan false positive untuk data borderline.
Setup Data Classification Taxonomy untuk Organisasi Indonesia
Taxonomy yang sesuai konteks Indonesia umumnya menggabungkan klasifikasi global dengan kategori lokal:
Layer 1 (Sensitivity): Public, Internal, Confidential, Restricted. Hampir semua organisasi memakai layer ini.
Layer 2 (Data Type): Personal Data (subjek UU PDP), Financial Data (subjek POJK), Health Data (subjek UU Kesehatan), Trade Secret (IP), Project Information, Customer Information.
Layer 3 (Regulatory Context): UU PDP General, UU PDP Sensitif, POJK Kerahasiaan Nasabah, BSSN Strategic, Trade Secret. Ini membantu evaluasi konteks compliance saat policy applied.
Layer 4 (Business Context): Customer Acquisition, R&D, M&A Pipeline, Financial Reporting, dll. Memungkinkan policy spesifik per business unit atau project.
PARAMA membantu klien design taxonomy yang sesuai konteks: berapa layer, label apa yang dipakai, mapping ke regulasi yang relevan. Taxonomy yang terlalu rumit malah membingungkan; terlalu sederhana tidak memberi granularity yang dibutuhkan.
Step-by-Step Implementasi Data Classification Bersama PARAMA
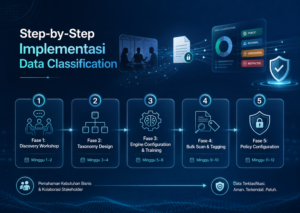
Fase 1 (Minggu 1-2): Discovery Workshop dengan Business Stakeholder
Tim PARAMA mengadakan workshop dengan business stakeholder dari masing-masing departemen utama: Finance, Legal, HR, Operations, R&D. Tujuan: identifikasi apa saja data sensitif yang dimiliki masing-masing departemen, lokasi penyimpanan, dan kewajiban regulasi yang relevan. Output: data inventory awal dengan ownership yang jelas.
Fase 2 (Minggu 3-4): Taxonomy Design dan Approval
Berdasarkan workshop, tim PARAMA design taxonomy 4-layer yang sesuai konteks klien. Taxonomy di-review dan disetujui oleh stakeholder utama (CIO, DPO, Legal Counsel). Output: taxonomy document yang resmi.
Fase 3 (Minggu 5-8): Engine Configuration dan Training
Tim PARAMA konfigurasi engine klasifikasi Digital Guardian: regex pattern untuk format ID Indonesia, dictionary lookup dari list kata kunci yang disetujui klien, dan ML classifier training dengan sample dokumen dari klien untuk setiap klasifikasi. Validasi akurasi dengan subset data dan tuning untuk menurunkan false positive di bawah 5%.
Fase 4 (Minggu 9-10): Bulk Scan dan Tagging
Engine running pada seluruh data inventory klien (di endpoint, network share, dan cloud). Setiap dokumen di-tag dengan klasifikasi yang sesuai. Review hasil dengan tim klien — untuk dokumen di tahap borderline, manual review dan approve klasifikasi yang tepat.
Fase 5 (Minggu 11-12): Policy Configuration Berbasis Klasifikasi
Berdasarkan klasifikasi yang sudah established, tim PARAMA konfigurasi policy DLP yang sesuai: restriction untuk data Restricted, monitoring untuk Confidential, dll. Output: policy framework production-ready.
Mengapa PARAMA sebagai Implementation Partner Data Classification
PARAMA adalah Authorized Partner Fortra (vendor Digital Guardian) untuk Indonesia. Kami bukan sekadar reseller — tim PARAMA telah ter-sertifikasi langsung oleh Fortra untuk implementasi Endpoint DLP, Network DLP, dan Cloud DLP, termasuk integrasi dengan platform Managed Detection and Response (MDR).
Lima alasan perusahaan Indonesia memilih PARAMA sebagai implementation partner Digital Guardian:
Pertama, sertifikasi ISO 27001 di tim implementasi. Setiap engineer PARAMA yang menangani deployment Digital Guardian sudah lulus pelatihan information security management system (ISMS) sesuai ISO 27001, memastikan implementasi DLP tidak sekadar fungsional tapi juga compliant dengan best practice global.
Kedua, ekspertise spesifik untuk UU PDP Indonesia. Tim PARAMA sudah mendalami Undang-Undang Perlindungan Data Pribadi (UU No. 27 Tahun 2022) yang berlaku penuh Oktober 2024. Setiap kebijakan DLP yang kami konfigurasi selaras dengan kewajiban pengendali dan prosesor data pribadi yang diatur regulator KEMKOMDIGI dan BSSN.
Ketiga, implementation team lokal yang berbahasa Indonesia. Tidak perlu komunikasi via vendor luar negeri yang berbeda zona waktu. Sesi pelatihan staf, dokumentasi runbook, dan response insiden bisa dilakukan dalam Bahasa Indonesia — mempercepat adopsi internal dan menurunkan friction operasional.
Keempat, coverage lengkap semua module Digital Guardian dalam satu engagement. PARAMA bisa mengelola Endpoint DLP (proteksi data di laptop/desktop karyawan), Network DLP (deteksi exfiltration via email/web gateway), dan Cloud DLP (proteksi M365 dan Google Workspace) sebagai satu unified deployment. Klien tidak perlu vendor berbeda untuk tiap module.
Kelima, akses ke Digital Guardian sebagai Gartner Magic Quadrant Leader DLP. Fortra Digital Guardian telah dinilai sebagai Leader di Gartner Magic Quadrant for Data Loss Prevention secara konsisten, dan Forrester Wave untuk DLP & EDR. Ini bukan klaim marketing — ini validasi industri yang dipakai untuk justifikasi pembelian ke C-suite dan Board.
Pertanyaan Umum tentang Data Classification
Baca Juga – Artikel Terkait dari Parama Solusi
- panduan Digital Guardian DLP Indonesia
- Endpoint DLP Digital Guardian
- Network DLP Digital Guardian
- Cloud DLP Digital Guardian untuk M365 & Workspace
- SecIron Mobile App Security family [fallback – target final: https://paramasolusi.com/seciron/]
Referensi Eksternal
FAQ – Pertanyaan Umum
Berapa lama proses bulk scan dan tagging awal? Apakah mengganggu produktivitas?
Untuk organisasi dengan terabyte data, bulk scan awal bisa berlangsung 1-4 minggu tergantung resource. Scan ini dilakukan di background dengan throttling — produktivitas user tidak terganggu. Setelah baseline scan selesai, incremental scan untuk data baru cepat (real-time atau near real-time tergantung volume).
Bagaimana jika engine klasifikasi salah klasifikasi dokumen?
Setiap dokumen memiliki opsi manual override — user atau approver dapat re-classify dokumen yang salah klasifikasi otomatisnya. Override ini juga menjadi training data untuk ML classifier sehingga akurasi meningkat seiring waktu. Tim PARAMA memonitor akurasi klasifikasi sebagai bagian dari ongoing tuning.
Apakah klasifikasi yang sudah dibuat di Digital Guardian bisa di-sync ke Microsoft Sensitivity Label?
Ya. Digital Guardian Cloud DLP dapat sync klasifikasi ke Microsoft Sensitivity Label di M365 atau Google Drive Label di Workspace. Ini berguna kalau klien sudah investasi di native labeling — tidak perlu klasifikasi paralel di dua tempat.
Bisakah klasifikasi diterapkan retroaktif ke dokumen lama?
Ya. Bulk scan awal mencakup semua dokumen di scope: dokumen baru, lama, di endpoint, network share, dan cloud. Semua dokumen yang ter-scan akan tertagi sesuai klasifikasi. Untuk dokumen sangat lama (di backup archive offline), klasifikasi diterapkan saat dokumen di-restore.
Apa beda antara klasifikasi otomatis dengan klasifikasi manual oleh user?
Klasifikasi otomatis: engine mengevaluasi dokumen dan menetapkan klasifikasi tanpa intervensi user. Klasifikasi manual: user (biasanya dokumen owner) memilih klasifikasi saat membuat atau mengirim dokumen. Praktik terbaik: kombinasi keduanya — otomatis untuk volume, manual untuk dokumen kritis yang user paling tahu konteks-nya. PARAMA membantu klien design balance yang tepat.
Apakah klasifikasi membantu kepatuhan audit ISO 27001 atau SOC 2?
Ya. Data classification adalah requirement eksplisit di ISO 27001 Annex A.8 (Information classification) dan kontrol terkait di SOC 2. Bukti klasifikasi yang otomatis dan terdokumentasi via Digital Guardian memudahkan audit response — auditor dapat melihat real-time klasifikasi data, log perubahan, dan policy enforcement yang menerapkan klasifikasi.
Hubungi Tim PARAMA – Konsultasi Awal
Konsultasi Implementasi Digital Guardian DLP untuk Perusahaan Anda — Bicara dengan tim PARAMA tentang threat profile organisasi, kewajiban UU PDP, dan tier Digital Guardian yang fit. Kami menyediakan free initial assessment (1 jam, no commitment) untuk memetakan kondisi proteksi data Anda saat ini dan area prioritas. Hubungi tim PARAMA via halaman kontak atau telepon kantor kami. Whitepaper teknis tersedia atas permintaan untuk decision-maker yang ingin deep-dive ke arsitektur Digital Guardian sebelum diskusi awal.
—
Author: Tim PARAMA Solusi + reviewed oleh Banana Digital Boost SEO team
Schema deployed via mu-plugin: Article (Yoast) + FAQPage +